Så anpassar vi kodamera.se för AI
llms.txt, strukturerad data, vilka AI-crawlers ska tillåtas? Begreppen och tillvägagångssätten är många, här beskriver vi hur vi gjort på vår webbplats.

Vi skrev tidigare om hur du optimerar för AI-sökmotorer. Den artikeln handlade om vad man bör göra. Den här handlar om vad vi själva har gjort, på den här webbplatsen, och varför.
Varför maskinläsbarhet blivit en egen fråga
En traditionell sökmotor listar länkar och låter användaren välja. En svarsmotor läser, sammanfattar och citerar, ofta utan att besökaren klickar sig vidare. Skillnaden får en praktisk följd: det räcker inte att innehållet finns och går att hitta. Det måste också gå att tolka av en maskin som kan återge det korrekt för någon annan.
I praktiken handlar det mindre om knep och mer om hygienfaktorer. En sida med tydlig struktur, korrekt uppmärkning och ärliga signaler är lättare att citera rätt. Den som saknar det riskerar att antingen citeras fel eller missas helt.
llms.txt: en annan slags sajtkarta
llms.txt är en enkel textfil i roten av webbplatsen som beskriver vad sajten innehåller. Konventionen kommer från llmstxt.org och består av en rubrik, en kort sammanfattning, och sedan länkar grupperade i avsnitt med en rad text per länk.
Vår ligger på kodamera.se/llms.txt, den genereras från Sanity, samma innehåll som driver resten av sajten. Det betyder att den inte hamnar ur synk, publicerar vi en ny tjänst finns den i filen nästa gång den hämtas.
Först listas våra tjänster, filens uppgift är att svara på ”vad gör det här företaget”? Därav hamnar våra fyra affärsområden överst, därefter de enskilda tjänsterna grupperade på samma sätt som på tjänstesidan, och först därefter kundcase och artiklar.
Det vi väljer att ha med i vår sitemap vill vi också ha med i vår llms.txt fil. När innehållet till filen hämtas baseras hämtningen på samma noindex-flagga som sitemapen för att hålla dem i synk.
Samma innehåll, två format
En webbsida byggs med den klassiske besökaren i åtanke, klassiska element och gränssnitts-komponenter som t.ex navigation är helt nödvändiga. För en AI-modell är vissa av de sakerna bara brus.
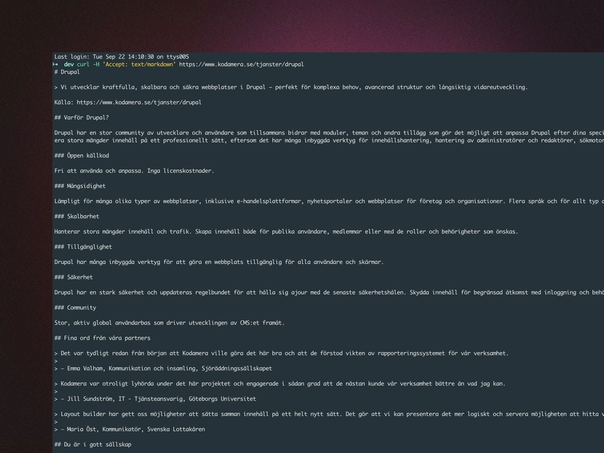
Varje sida på kodamera.se finns därför i två format, en anpassad för vanliga besökare, den andra för AI-modeller. Accept: text/markdown får samma innehåll som ren text — rubriker, brödtext och länkar, inget annat.
Texten hämtas från Sanity, precis som för den vanliga besökaren.
Vilka AI-crawlers ska man släppa in?
Det finns inget självklart svar i dag, men det blir lättare om man vet att botarna gör två olika saker.
Några av dem, som ChatGPT:s och Perplexitys sökbotar, hämtar innehåll för att kunna svara på en fråga just då. De berättar var svaret kommer ifrån och skickar besökaren vidare till dig. Dem finns det få skäl att stänga ute.
Andra samlar in text för att träna framtida AI-modeller. De länkar inte tillbaka. Här får du väga två saker mot varandra: ditt innehåll kan finnas med i modeller som väldigt många använder, men utan att någon får veta att det kom från dig.
Vi släpper in båda. Vi hjälper våra kunder att synas i AI-sök, och då vore det märkligt att stänga dörren för de motorer som gör just det.
Strukturerad data som genereras, inte klistras in
Strukturerad data låter en maskin förstå vad en sida innehåller: att Kodamera är en organisation och inte bara ett ord, att en artikel har en författare och ett datum, och var sidan hör hemma i hierarkin. Läsaren ser den aldrig. Sökmotorer och språkmodeller läser den varje gång.
Vi genererar all uppmärkning ur innehållet i Sanity i stället för att skriva den för hand:
- Organization på hela sajten, med adress
- Service på varje tjänstesida
- Article på artiklar, med författare och datum
- BreadcrumbList på undersidor, med samma data som den synliga brödsmulan
- FAQPage på sidor med frågor och svar
- WebSite och ItemList på översiktssidor
Företaget förekommer bara på ett ställe. Organisationsnoden har ett eget id som resten av uppmärkningen pekar tillbaka på, i stället för att företagsnamnet upprepas lite här och var. Två noder som båda gör anspråk på att vara företaget tvingar läsaren att välja, och valet faller inte nödvändigtvis på den mest kompletta. Det gäller sökmotorn lika mycket som språkmodellen.
Den största vinsten är ändå att uppmärkningen inte kan bli inaktuell. Byter en artikel författare följer strukturerad data med. Handskriven markup gör inte det, och till slut påstår den saker om sidan som inte längre stämmer.
En sitemap som stämmer
En sitemap är bara en lista, men lastmod är ett påstående: den här sidan ändrades då. Rör sig fältet när innehållet står still slutar sökmotorn lita på det, och den gör det inte per sida utan för hela sajten.
Vår sitemap är ett index över fyra kategorier: sidor, tjänster, kundcase och artiklar. Uppdelningen gör att vi ser i Search Console vilken sorts innehåll som inte indexeras, i stället för att få en enda siffra.
Datumet speglar när innehållet faktiskt ändrades. En omskriven metabeskrivning flyttar det inte, för det är ingen innehållsändring. Vet vi inte säkert utelämnar vi fältet hellre än gissar.
changefreq och priority är borta. Google har i åratal sagt att de ignoreras, och "veckovis, prioritet 0,5" på tvåhundra artiklar säger ingenting.
Ett fel som går att läsa
Det mesta som skrivs om AEO handlar om sidor som finns. Minst lika viktigt är vad som händer när en adress inte gör det.
Statuskoden måste vara sann. Det låter självklart och är lättare att missa än man tror. Med partiell rendering hinner ett sidskal skickas iväg med kod 200 innan servern konstaterat att sidan saknas, och då står det OK överst på ett tomt resultat. Adresser med punkt i, som /nagot.json, är särskilt utsatta: de undantas ofta från just den kontroll som hade fångat felet. Testa själv. Hämta en adress du vet inte finns och titta på statuskoden, inte på sidan.
Felet ska komma i samma format som frågan. Den som bett om markdown får en 404 i markdown, med en mening om vad som hänt och länkar vidare till llms.txt och sitemapen. Anrop under /api svarar med JSON: en felkod, ett meddelande och en rad om vad man kan göra i stället. En agent kan inte tolka en HTML-felsida och ska inte behöva.
En 404 är också en sida och förtjänar samma omsorg som resten. Det bryr sig ingen maskin om. Människan som hamnade fel gör det.
Det som inte syns men ändå räknas
Semantisk HTML, rubriker i ordning, länktexter som går att förstå utan omgivande text. Sidorna fungerar utan JavaScript. Tillgängligheten testas automatiskt vid varje kodändring.
Inget av det är AEO-specifikt. Det är samma grundarbete som gör en sida användbar för en skärmläsare eller en långsam uppkoppling.
Vi mätte oss själva
Allt ovan är sådant vi försöker få rätt. Men det är lätt att tro att den egna sajten är i bättre skick än den är, så vi lät någon annan mäta. is-agentic.com testar hur väl en webbplats fungerar för agenter: statuskoder, maskinläsbara format, strukturerad data, felsvar.
Första körningen gav 65 av 100, och vi hittade saker vi inte visste om. Adresser som svarade OK på sidor som inte fanns. Felmeddelanden i HTML där ett program väntar sig JSON. Ingen maskinläsbar beskrivning alls av vad sajten erbjuder. Sådant märks inte när man surfar runt på sin egen sajt, för allt ser ju ut att fungera.
Efter en dags arbete, ungefär det som står i den här artikeln, låg vi på 96 vid mätningen i september 2026. Poängen som saknas hänger på saker en byrå inte har: ett publikt API, ett CLI-verktyg, självbetjänade API-nycklar. Vi hade kunnat bygga ett API ingen frågat efter bara för att fylla i rutorna. Det kändes fel.
Kör den gärna på er egen sajt. Det tar en minut, ni får en lista att beta av, och den är konkret på ett sätt som de flesta SEO-verktyg inte är. Behöver ni hjälp att beta av listan vet ni var vi finns.
Vad det här inte löser
Tekniken gör att AI-tjänsterna hittar och förstår innehållet. Om de sedan använder det i sina svar avgörs av vad som faktiskt står där.
En svarsmotor väljer källa efter vad som faktiskt besvarar frågan. Perfekt strukturerad data på en tunn text hjälper ingen. Vi arbetar med den tekniska halvan, alltså uppmärkning, struktur och indexering. Den andra halvan är innehåll som säger något.
Gränsen är värd att vara tydlig med, för den går rakt genom det som brukar säljas som AEO.
Läs vidare
- Räcker vanlig SEO för att synas i ChatGPT? — vad som överlappar med teknisk SEO och vad som inte gör det.
- Hur väljer AI-sökmotorer vilka källor de citerar? — vad som rimligen avgör, och vilka siffror man inte ska lita på.
- Hur vet du om ditt företag nämns när kunder frågar ChatGPT? — en mätmetod som tar en eftermiddag och inget verktyg.
- AI i CMS: vad det faktiskt gör — tre saker som kallas samma, och vad man bör fråga först.

Tjänster inom området
AEO
Vi implementerar teknisk AEO för att säkerställa att AI-drivna svarsmotorer som ChatGPT, Perplexity och Google AI Overviews kan hitta, förstå och citera ditt innehåll. Vi arbetar med strukturerad data (schema markup-format), semantisk HTML och maskinläsbar innehållsstruktur för att optimera för featured snippets och direktsvar. Vi hanterar den tekniska implementeringen – inte innehållsstrategi eller copywriting.
Teknisk SEO
Vi implementerar och optimerar teknisk SEO för att säkerställa att er webbplats är korrekt indexerad och presterar väl i sökmotorerna. Vi arbetar med strukturerad data, Core Web Vitals, crawlbarhet, sidhastighet, canonical-taggar, sitemaps, robots.txt och hreflang. Vi erbjuder inte sökordsanalys, innehållsproduktion eller länkbyggnad – vårt fokus ligger på den tekniska grunden.